6장. 문서 기반 챗봇
임베딩: 글을 숫자 목록으로
지도 앱에서 가게마다 위도와 경도라는 숫자 두 개가 붙어 있습니다. 숫자 두 개만 있으면 "우리 집에서 가장 가까운 가게"를 계산으로 찾을 수 있습니다. 임베딩은 글에 이런 좌표를 붙이는 일입니다. 다만 숫자가 두 개가 아니라 수백, 수천 개이고, 뜻이 비슷한 글끼리 가까운 자리에 놓이도록 만듭니다.
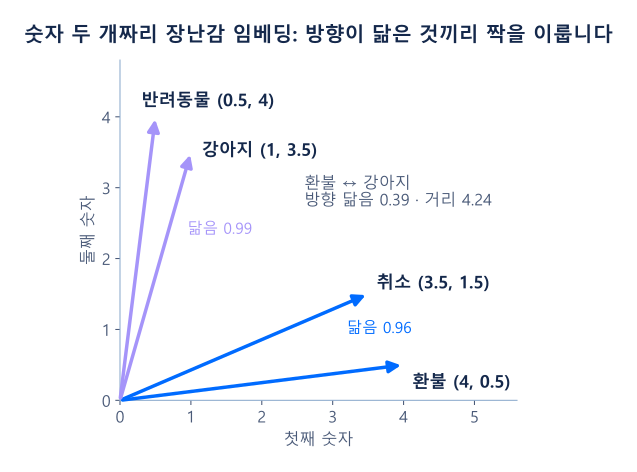
그림은 숫자가 두 개뿐인 장난감 임베딩입니다. 화살표 하나가 낱말 하나이고, 끝점이 그 낱말의 좌표입니다. 파랑 화살표인 "환불"과 "취소"는 오른쪽으로 낮게, 보라 화살표인 "반려동물"과 "강아지"는 위로 높게 뻗어 있어서 방향이 닮은 것끼리 짝을 이룹니다. 여기서 가게의 위도·경도가 임베딩의 숫자들, "가까운 가게 찾기"가 검색입니다. 비유와 다른 점은, 지도의 좌표는 실제 땅의 위치지만 임베딩의 숫자 하나하나는 사람이 읽을 수 있는 뜻(예: "돈과 관련된 정도")이 정해져 있지 않다는 것입니다. 수천 개의 숫자가 모여 전체로 뜻을 나타냅니다.
가깝다를 재는 두 가지
| 재는 것 | 계산 | 값의 뜻 | 쓰는 곳 |
|---|---|---|---|
| 거리 | 두 끝점 사이의 직선 길이. 칸마다 차이를 제곱해 더하고 제곱근 | 0 에 가까울수록 가깝다 | FAISS 의 기본 점수(제곱한 값) |
| 방향 닮음(코사인 유사도) | 칸마다 곱해 더한 값을 두 화살표 길이의 곱으로 나눈다 | 1 에 가까울수록 같은 방향 | 임베딩끼리 견줄 때 |
| 둘의 관계 | 길이를 1 로 맞춘 화살표라면 거리의 제곱 = 2 - 2 × 방향 닮음 | 한쪽이 크면 다른 쪽이 작다 | 이 장의 두 임베딩 모두 길이가 1 |
짧은 예시
그림의 장난감 좌표로 거리와 방향 닮음을 손으로 계산해 봅니다. 중학교에서 배운 피타고라스의 정리(두 변의 제곱의 합의 제곱근)가 거리입니다.
import math

# 숫자 두 개짜리 장난감 임베딩(그림과 같은 값). 진짜 임베딩은 숫자가 1536 개쯤 된다
toy = {"환불": (4, 0.5), "취소": (3.5, 1.5), "반려동물": (0.5, 4), "강아지": (1, 3.5)}


def distance(a, b):
    # 칸마다 차이를 제곱해 더하고 제곱근을 씌운다
    return math.sqrt(sum((x - y) ** 2 for x, y in zip(a, b)))


def cosine(a, b):
    # 칸마다 곱해 더한 값 ÷ (a 의 길이 × b 의 길이)
    dot = sum(x * y for x, y in zip(a, b))
    return dot / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))


for w1, w2 in [("환불", "취소"), ("반려동물", "강아지"), ("환불", "강아지")]:
    a, b = toy[w1], toy[w2]
print(f"{w1}-{w2}: 거리 {distance(a, b):.2f}, 방향 닮음 {cosine(a, b):.2f}")환불-취소: 거리 1.12, 방향 닮음 0.96
반려동물-강아지: 거리 0.71, 방향 닮음 0.99
환불-강아지: 거리 4.24, 방향 닮음 0.39"환불"과 "취소", "반려동물"과 "강아지"는 방향 닮음이 0.96, 0.99 로 1 에 가깝고 거리도 1 안팎으로 짧습니다. "환불"과 "강아지"는 거리가 4.24 로 멀고 방향 닮음도 0.39 로 낮습니다. 진짜 임베딩도 이 계산을 그대로 하되, 숫자가 두 개가 아니라 1536 개라서 칸마다 곱하고 더하는 횟수만 많아집니다. 검색이란 결국 "질문의 화살표와 방향이 가장 닮은 조각의 화살표 찾기"입니다.
코드가 의미하는 것
이 코드는 지도 앱이 "가장 가까운 가게"를 고를 때 하는 계산을 손으로 해 보는 것입니다. 가게마다 좌표를 두고(toy), 두 가지 자로 가까움을 잽니다(거리와 방향 닮음).
| 코드 | 하는 일 | 챗봇에서 뜻하는 것 |
|---|---|---|
toy = {"환불": (4, 0.5), …} | 낱말마다 숫자 두 개짜리 좌표를 붙인다 | 임베딩 모델이 글마다 돌려주는 숫자 목록의 장난감 판입니다. 진짜는 칸이 1536 개쯤 됩니다 |
distance(a, b) | 칸마다 차이를 제곱해 더하고 제곱근을 씌운다 | 두 끝점이 얼마나 떨어져 있는지입니다. FAISS 가 기본으로 매기는 점수가 이 거리(의 제곱)입니다 |
cosine(a, b) | 칸마다 곱해 더한 값을 두 길이의 곱으로 나눈다 | 두 화살표가 같은 쪽을 가리키는 정도입니다. 글의 길이와 상관없이 뜻의 방향만 견줄 때 씁니다 |
for w1, w2 in [...] | 세 쌍을 같은 두 자로 잰다 | 질문 하나를 조각 여러 개와 견줘 가장 가까운 것을 고르는 검색의 축소판입니다 |
결과에서 읽을 것은 두 가지입니다.
- 두 자가 같은 쪽을 가리킵니다. 거리가 짧은 "반려동물-강아지"(0.71)가 방향 닮음도 가장 높고(0.99), 거리가 먼 "환불-강아지"(4.24)는 방향 닮음도 가장 낮습니다(0.39). 어느 자로 재도 가까운 순서는 같습니다.
- 좌표만 잘 매기면 검색은 계산 문제입니다. 이 계산 자체는 뜻을 모릅니다. "강아지"와 "반려동물"이 가까운 것은 좌표를 그렇게 매겼기 때문이고, 좌표를 잘 매기는 일이 임베딩 모델의 몫입니다.
주의할 점
- 진짜 임베딩 모델은 많은 글을 읽으며 "같은 자리에 자주 오는 낱말은 뜻이 비슷하다"는 것을 배워 좌표를 정합니다. 그래서 글자가 하나도 겹치지 않는 "강아지"와 "반려동물"도 가까이 놓습니다. 다음 절의 연습용 임베딩은 이것을 못 합니다.
- 임베딩은 글을 쓰는 모델(ChatOpenAI)과 다른 모델입니다. 글을 받아 숫자 목록을 돌려줄 뿐 답을 쓰지 않습니다.