6장. 문서 기반 챗봇
실습 2 — 청킹 견주기와 조항 단위로 나누기
실습 1의 약관을 RecursiveCharacterTextSplitter 로 크기를 바꿔 가며 나누고, 조각 수와 평균 길이, 머리글이 섞인 조각, 조항이 둘 이상 섞인 조각을 표와 그래프로 견줍니다. 그다음 머리글을 지우고 "제N조" 앞에서 잘라, 조항 하나가 조각 하나가 되도록 나눠 out_ch06_chunks.csv 로 저장합니다. 이 파일은 실습 3, 4, 5와 프로젝트가 씁니다. 모델은 부르지 않습니다.
1단계. 크기 200 으로 나눠 보기
import re
import warnings

warnings.filterwarnings("ignore", category=DeprecationWarning)

import matplotlib.pyplot as plt
import pandas as pd
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 그래프의 한글 글꼴과 마이너스 기호
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

pages = PyPDFLoader("travel_terms.pdf").load()
HEADER = "구름다리여행 여행 약관 (연습용 가상 문서)"    # 실습 1에서 찾은 머리글

splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,      # 조각 하나의 최대 글자 수
    chunk_overlap=30,    # 이웃 조각과 겹칠 최대 글자 수
)
# split_documents: Document 목록을 조각 Document 목록으로. 쪽의 metadata 를 조각마다 물려준다
chunks = splitter.split_documents(pages)
print("쪽 4개 → 조각", len(chunks), "개")
for c in chunks[:3]:
print(f"[{c.metadata['page'] + 1}쪽, {len(c.page_content)}자]", c.page_content.replace("\n", " ")[:60], "…")쪽 4개 → 조각 12 개
[1쪽, 171자] 구름다리여행 여행 약관 (연습용 가상 문서) 제1장 총칙과 예약 제1조 목적 이 약관은 구름다리여행(이하 …
[1쪽, 186자] 제2조 예약의 성립 손님이 상품을 고르고 예약금을 낸 때 예약이 성립한다. 예약금은 상품 금액의 10%이며, …
[1쪽, 128자] 전부터의 변경은 취소 후 다시 예약하는 것으로 본다. 제4조 결제 신용카드, 계좌 이체, 여행 포인트로 낼 …코드가 의미하는 것 split_documents(pages) 는 쪽을 조각으로 나누면서 쪽의 metadata 를 조각마다 물려주므로, 잘게 나눠도 "몇 쪽에서 왔는지"를 잃지 않습니다. 다만 분할기는 글자 수만 보고 자르므로 머리글이 첫 조각에 붙고, 조항이 조각 경계에서 잘립니다. 이 단계는 "아무 손질 없이 나누면 어떤 조각이 생기는가"를 보는 기준선입니다.
2단계. 크기를 바꿔 가며 견주기
def describe(chunks):
    """조각 목록의 조각 수, 평균 길이, 머리글이 든 조각 수, 조항이 둘 이상 섞인 조각 수"""
    return {
        "조각 수": len(chunks),
        "평균 글자 수": round(sum(len(c.page_content) for c in chunks) / len(chunks), 1),
        "머리글 든 조각": sum(HEADER in c.page_content for c in chunks),
        "조항 섞인 조각": sum(len(re.findall(r"제\d+조 ", c.page_content)) >= 2 for c in chunks),
    }


rows = []
for size in [100, 200, 300, 500, 1000]:
    sp = RecursiveCharacterTextSplitter(chunk_size=size, chunk_overlap=30)
    rows.append({"chunk_size": size, **describe(sp.split_documents(pages))})

sizes = pd.DataFrame(rows).set_index("chunk_size")
print(sizes.to_string()) 조각 수 평균 글자 수 머리글 든 조각 조항 섞인 조각
chunk_size
100 28 71.4 4 0
200 12 158.6 4 8
300 8 229.5 4 7
500 5 363.4 4 4
1000 4 454.5 4 4코드가 의미하는 것 describe 는 조각 목록을 네 가지 숫자로 채점하는 작은 평가표이고, for size in [...] 는 같은 문서에 chunk_size 만 바꿔 그 채점을 되풀이합니다. 조각의 크기는 감으로 정하지 않고 이렇게 몇 가지 값을 견줘 고르는 설정값이라는 뜻입니다. "머리글 든 조각"과 "조항 섞인 조각"은 검색을 흐리는 두 원인을 따로 세는 칸입니다.
3단계. 그래프로 보기
fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))

# 왼쪽: 크기마다 조각 수
sizes["조각 수"].plot.bar(ax=axes[0], rot=0)
axes[0].set_title("chunk_size 와 조각 수")
axes[0].set_xlabel("chunk_size (글자)")
axes[0].set_ylabel("조각 수")

# 오른쪽: 크기마다 "조항 섞인 조각"이 전체에서 차지하는 비율
(sizes["조항 섞인 조각"] / sizes["조각 수"]).plot(ax=axes[1], marker="o")
axes[1].set_title("조항이 둘 이상 섞인 조각의 비율")
axes[1].set_xlabel("chunk_size (글자)")
axes[1].set_ylabel("비율")
axes[1].set_ylim(0, 1.05)

plt.tight_layout()
plt.show()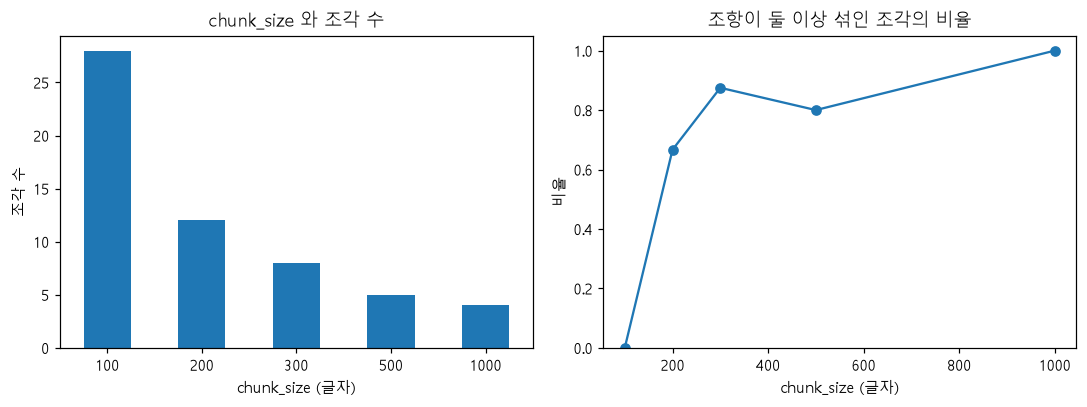
코드가 의미하는 것 왼쪽 막대는 색인의 크기(조각 수)를, 오른쪽 꺾은선은 조각의 품질(조항이 섞인 비율)을 그립니다. sizes["조항 섞인 조각"] / sizes["조각 수"] 처럼 개수를 비율로 바꾼 것은 조각 수가 다른 크기끼리 공정하게 견주려는 것입니다. 두 그래프를 나란히 두면 "작게 자르면 조각이 많아지고, 크게 자르면 섞인다"는 맞바꿈이 한눈에 보입니다.
4단계. 머리글 지우고 조항 단위로 나누기
from langchain_core.documents import Document

articles = []
for p in pages:
    # 머리글을 지우고, 줄바꿈과 겹친 빈칸을 빈칸 하나로 바꾼다
    text = p.page_content.replace(HEADER, "")
    text = re.sub(r"\s+", " ", text).strip()
    # (?=…): 그 자리 "앞"에서 자르되 "제N조 " 글자는 남긴다(앞을 내다보기, lookahead)
    parts = re.split(r"(?=제\d+조 )", text)
    chapter = parts[0].strip()                      # 첫 토막은 "제1장 총칙과 예약" 같은 장 제목
    for part in parts[1:]:
        number = re.match(r"제\d+조", part).group()      # 조각 맨 앞의 조항 번호
        articles.append(Document(
            page_content=part.strip(),
            metadata={"article": number, "chapter": chapter, "page": p.metadata["page"] + 1},
        ))

print("조항 단위 조각:", len(articles), "개")
print(describe(articles))
for d in articles[4:6]:
    print(d.metadata, "|", d.page_content[:50], "…")

saved = pd.DataFrame([{**d.metadata, "글자 수": len(d.page_content), "내용": d.page_content} for d in articles])
saved.to_csv("out_ch06_chunks.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch06_chunks.csv")조항 단위 조각: 16 개
{'조각 수': 16, '평균 글자 수': 101.6, '머리글 든 조각': 0, '조항 섞인 조각': 0}
{'article': '제5조', 'chapter': '제2장 취소와 환불', 'page': 2} | 제5조 손님이 취소할 때 출발 10일 전까지 취소하면 낸 돈을 전액 돌려준다. 출발 7일 …
{'article': '제6조', 'chapter': '제2장 취소와 환불', 'page': 2} | 제6조 회사가 취소할 때 모인 손님이 최소 인원에 못 미치면 회사는 출발 7일 전까지 알리 …
저장: out_ch06_chunks.csv코드가 의미하는 것 replace(HEADER, "") 와 re.sub(r"\s+", " ", text) 는 검색에 방해가 되는 군더더기를 덜어 내는 전처리이고, re.split(r"(?=제\d+조 )", text) 는 분할기 대신 문서의 짜임대로 칼질하는 일입니다. 조각마다 Document(..., metadata={"article": …, "chapter": …, "page": …}) 로 이름표를 달아 두었기 때문에, 이 조각이 검색되면 챗봇이 "제5조(2쪽)"처럼 출처를 붙일 수 있습니다. out_ch06_chunks.csv 로 저장해 두는 것은 색인 단계의 중간 결과를 한 번만 만들고 실습 3부터 다시 쓰려는 것입니다.
이 실습이 뜻하는 것
이 실습은 오픈북 시험을 앞두고 책에 쪽지를 붙이는 방법을 몇 가지 시험해 보는 일과 같습니다. 일정한 분량마다 쪽지를 붙여 보고(1단계), 분량을 바꿔 가며 견주고(2·3단계), 마지막에는 쪽 위의 머리글은 무시하고 조항마다 쪽지를 하나씩 붙입니다(4단계). 여기서 쪽지 하나가 조각, 쪽지 사이의 분량이 chunk_size, 조항마다 붙인 쪽지가 조항 단위 조각입니다. 비유와 다른 점은, 사람은 쪽지를 단원의 경계에 붙이지만 분할기는 글자 수만 보고 빈칸이나 줄바꿈에서 자른다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 크기 200 | 조각 12개 | 첫 조각에 머리글이 들어 있고, 셋째 조각은 제3조의 뒷부분("전부터의 변경은…")으로 시작합니다 |
| 2. 크기 견주기 | 28·12·8·5·4개 | 크기를 키울수록 조각이 줄고 평균 길이가 늘어납니다. 머리글은 어느 크기에서나 4개 조각에 섞입니다 |
| 3. 그래프 | 비율 0 → 0.67 → 0.88 → 0.8 → 1.0 | 크기 100 은 조항이 섞이지 않는 대신 71자 안팎으로 잘게 쪼개고, 200 부터는 조각 대부분에 조항이 둘 이상 섞입니다 |
| 4. 조항 단위 | 16개, 머리글 0, 섞임 0 | 조항 하나가 조각 하나가 되어 평균 101.6자이고, 머리글과 섞인 조항이 모두 사라졌습니다 |
한 줄로 줄이면, 글자 수로만 자르면 "작으면 뜻이 잘리고 크면 규정이 섞인다"는 사이에서 고를 수밖에 없지만, 문서의 짜임(조항)대로 자르면 둘 다 피할 수 있다는 것을 숫자로 확인한 실습입니다. 크기 200 의 조각 12개 가운데 8개에 조항이 둘 이상 섞였고 4개에 머리글이 들었습니다. 조항 단위로 나눈 16개는 둘 다 0 입니다. 조각의 metadata 에 조항 번호와 쪽을 넣어 둔 것도 나중에 근거를 보여 줄 때 쓰입니다.
코드 설명
RecursiveCharacterTextSplitter(chunk_size=…, chunk_overlap=…)는 분할기를 만들고,split_documents(pages)가 쪽마다 나눠 조각Document목록을 돌려줍니다. 조각의metadata에는 원래 쪽의page가 그대로 남습니다.describe의sum(조건 for c in chunks)는 조건이 True 인 조각의 수입니다. True 는 1, False 는 0 으로 더해집니다.re.sub(r"\s+", " ", text)는 줄바꿈과 겹친 빈칸(\s+, 빈칸 같은 글자 하나 이상)을 빈칸 하나로 바꿉니다. PDF 가 문장 가운데에서 줄을 바꾼 곳이 다시 이어집니다.re.split(r"(?=제\d+조 )", text)는 "제N조 " 바로 앞에서 글을 자릅니다.(?=…)는 그 글자를 지우지 않고 자리만 찾으므로 조항 번호가 조각 맨 앞에 남습니다.- 조항 조각의
metadata에article(조항),chapter(장),page(쪽)를 넣었습니다. 나중에 답의 근거를 "제5조(2쪽)"처럼 보여 줄 때 이 값을 씁니다.