4장. 대화형 챗봇과 메모리 전략
실습 5 — Window 메모리로 최근 대화만 남기기
1장의 열 번 주고받은 대화(chat_log.json)를 LangChain 메시지로 바꾸고, trim_messages 의 토큰 상한을 바꿔 가며 마지막 정리 질문을 보낼 때 무엇이 남는지 봅니다. 토큰은 tiktoken 의 o200k_base 사전으로 셉니다. 대화는 연습용으로 지어낸 것이고, 모델은 부르지 않으므로 API 키가 없어도 됩니다.
1단계. 대화를 메시지로 바꾸고 토큰 세기
import json
from pathlib import Path

import matplotlib.pyplot as plt
import tiktoken
from langchain_core.messages import convert_to_messages

# 한글 글꼴과 빼기 기호 설정
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

enc = tiktoken.get_encoding("o200k_base")


def count_tokens(messages):
    """메시지 목록의 글을 tiktoken 으로 세어 더한다(역할 표시 토큰은 빼고 센 어림값)"""
    return sum(len(enc.encode(m.content)) for m in messages)


# convert_to_messages: {"role", "content"} 사전을 SystemMessage, HumanMessage, AIMessage 로 바꾼다
msgs = convert_to_messages(json.loads(Path("chat_log.json").read_text(encoding="utf-8")))
# 마지막 정리 질문을 보내는 순간의 기록: 마지막 답 하나를 뺀 20개
sent = msgs[:-1]

print("메시지:", len(msgs), "개 / 보낼 기록:", len(sent), "개")
print("역할:", [m.type for m in sent[:5]], "...")
print("마지막 질문:", sent[-1].content)
print("모두 보내면:", count_tokens(sent), "토큰")메시지: 21 개 / 보낼 기록: 20 개
역할: ['system', 'human', 'ai', 'human', 'ai'] ...
마지막 질문: 지금까지 말한 일정을 정리해 주세요.
모두 보내면: 317 토큰코드가 의미하는 것 convert_to_messages 로 1장의 대화 파일을 LangChain 메시지로 되살리면 trim_messages 같은 부품에 바로 넣을 수 있습니다. sent = msgs[:-1] 은 마지막 정리 질문을 보내는 순간을 재현한 것으로, 모델이 그 질문에 답하려고 받는 기록이 이 20개입니다. count_tokens 는 Window 의 상한을 재는 자이자 요금을 어림하는 자입니다.
2단계. 상한 100 토큰으로 잘라 보기
from langchain_core.messages import trim_messages

kept = trim_messages(
    sent,
    max_tokens=100,              # 남길 토큰의 상한
    token_counter=count_tokens,  # 토큰을 세는 함수
    strategy="last",             # 뒤에서부터 남긴다
    include_system=True,         # 시스템 메시지는 늘 남긴다
    start_on="human",            # 남긴 기록이 사람의 질문으로 시작하게 한다
)
for m in kept:
    print(f"{m.type:6} {len(enc.encode(m.content)):3} 토큰 | {m.content}")
print("남은 메시지:", len(kept), "개 /", count_tokens(kept), "토큰")system 25 토큰 | 너는 구름다리여행의 친절한 여행 비서다. 짧고 정확하게 답한다.
human 12 토큰 | 렌터카는 언제 빌리는 게 좋아요?
ai 21 토큰 | 공항에 내리자마자 빌리시면 첫날부터 바로 움직일 수 있습니다.
human 9 토큰 | 짐은 얼마나 가져가도 되나요?
ai 17 토큰 | 국내선 상품은 15kg 짐 한 개가 포함되어 있습니다.
human 12 토큰 | 지금까지 말한 일정을 정리해 주세요.
남은 메시지: 6 개 / 96 토큰코드가 의미하는 것 trim_messages 에 token_counter=count_tokens 를 넘기면 본문 예시의 메시지 개수 대신 토큰으로 책상 크기를 잽니다. 메시지마다 토큰 수를 함께 찍은 것은 어느 메시지까지 들어가고 어디서 잘렸는지 따라가 보기 위해서입니다. 챗봇에서는 이 kept 가 프롬프트의 기록 자리에 들어갈 목록입니다.
3단계. 상한을 바꿔 가며 견주기
import pandas as pd

rows = []
for limit in [50, 100, 150, 200, 250, 300, 350]:
    kept = trim_messages(sent, max_tokens=limit, token_counter=count_tokens,
                         strategy="last", include_system=True, start_on="human")
    rows.append({
        "상한": limit,
        "남은 메시지": len(kept),
        "남은 토큰": count_tokens(kept),
        # 앞에서 말한 조건이 남았는지 글자로 확인한다
        "2박 3일": any("2박 3일" in m.content for m in kept),
        "아이 둘": any("아이 둘" in m.content for m in kept),
    })

window = pd.DataFrame(rows)
print(window.to_string(index=False))

window.to_csv("out_ch04_window.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch04_window.csv") 상한 남은 메시지 남은 토큰 2박 3일 아이 둘
50 2 37 False False
100 6 96 False False
150 8 127 False False
200 12 190 False False
250 14 223 False False
300 18 289 True True
350 20 317 True True
저장: out_ch04_window.csv코드가 의미하는 것 상한을 일곱 가지로 바꿔 같은 자르기를 되풀이하는 것은 책상 크기를 정하기 전에 미리 재 보는 일입니다. "2박 3일", "아이 둘" 열은 토큰 수로는 보이지 않는 "잊은 것"을 표에 올려, 아끼는 토큰과 잃는 조건을 한 줄에서 견주게 합니다. 여행 비서의 상한을 정할 때는 이 두 쪽을 함께 보고 고릅니다.
4단계. 그래프로 보기
ax = window.plot(x="상한", y="남은 토큰", marker="o", legend=False, figsize=(7.5, 3.8))
# 모두 보낼 때의 토큰을 가로 점선으로 긋는다
ax.axhline(count_tokens(sent), linestyle="--", color="gray")
ax.text(50, count_tokens(sent) + 6, "모두 보내기", color="gray")
ax.set_title("토큰 상한에 따라 남는 기록의 토큰")
ax.set_xlabel("max_tokens (상한)")
ax.set_ylabel("남은 토큰 수")
ax.set_ylim(0, count_tokens(sent) + 40)
plt.show()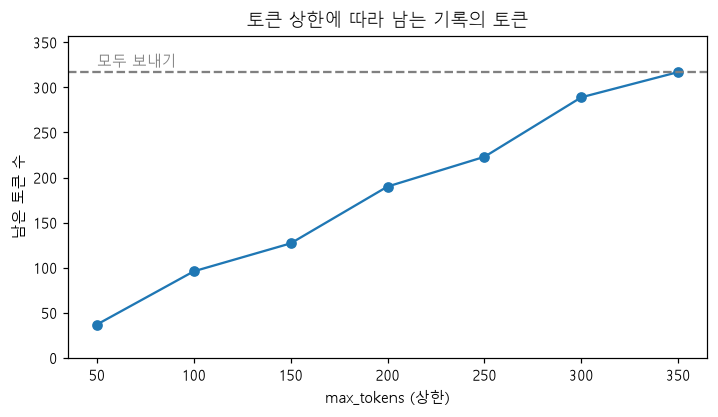
코드가 의미하는 것 window.plot 의 선은 상한을 올릴 때 실제로 보내는 양이 어떻게 늘어나는지, axhline 의 점선은 아무것도 자르지 않을 때의 양을 보여 줍니다. 선이 점선에 다가갈수록 Window 로 아끼는 몫이 줄어든다는 것을 한눈에 읽게 하는 그림입니다.
이 실습이 뜻하는 것
이 실습은 책상 크기를 바꿔 가며 기록철의 몇 장까지 펼칠 수 있는지 재 보는 일과 같습니다. 철의 장마다 분량을 재고(1단계), 책상 하나에 맞춰 펼쳐 보고(2단계), 책상 크기를 일곱 가지로 바꿔 보고(3단계), 그림으로 견줍니다(4단계). 여기서 책상 크기가 max_tokens, 펼친 장이 남은 메시지입니다. 비유와 다른 점은, trim_messages 는 장을 반만 펼치는 일 없이 메시지 단위로 통째로 남기거나 뗀다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 토큰 세기 | 보낼 기록 20개, 317 토큰 | 마지막 질문까지 모두 보내면 1장 프로젝트의 열째 요청과 같은 317 토큰입니다 |
| 2. 상한 100 | 6개, 96 토큰 | 시스템과 마지막 두 쌍(렌터카, 짐)과 정리 질문만 남았습니다 |
| 3. 상한 50 | 2개, 37 토큰 | 시스템과 정리 질문만 남았습니다. 앞의 대화는 하나도 가지 않습니다 |
| 3. 상한 250 까지 | 2박 3일 False, 아이 둘 False | 상한을 250 으로 올려도 조건이 든 둘째 메시지까지는 닿지 않습니다 |
| 3. 상한 300 | 18개, 289 토큰, True | 시스템과 첫 질문만 빼고 다 보내야 "2박 3일"과 "아이 둘"이 남습니다 |
| 4. 그래프 | 상한을 따라 오르는 선 | 상한 350 에서 선이 점선(모두 보내기 317)에 닿았습니다 |
한 줄로 줄이면, Window 메모리는 상한을 낮출수록 토큰을 확실히 아끼지만, 앞에서 말한 조건은 상한을 거의 "모두 보내기"만큼 올려야 지켜진다는 것을 확인한 실습입니다. 상한 100 에서 남은 96 토큰은 모두 보내기 317 토큰의 3분의 1 아래입니다. 그런데 "2박 3일, 아이 둘"은 대화 맨 앞(둘째 질문)에 있어서 상한 250 까지는 잘려 나갔고, 300 이 되어서야 남았습니다. 상한이 50 씩 늘어도 남은 토큰이 고르게 늘지 않는 것은 trim_messages 가 메시지를 통째로 남기거나 떼기 때문입니다. 조건을 지키면서 토큰도 아끼려면 실습 6의 요약이 필요합니다.
코드 설명
convert_to_messages는 1장의{"role": "user", "content": …}사전을HumanMessage같은 LangChain 메시지로 바꿉니다. user 는 human, assistant 는 ai 가 됩니다.count_tokens는 메시지 목록을 받아 토큰 수를 돌려주는 함수입니다.trim_messages의token_counter에 넘기면 상한을 토큰으로 셉니다.len을 넘기면 메시지 개수로 셉니다.trim_messages(…, strategy="last", include_system=True, start_on="human")은 시스템 메시지를 지키고, 뒤에서부터 상한까지 남기고, 남은 기록이 질문으로 시작하게 다듬습니다.any("2박 3일" in m.content for m in kept)는 남은 메시지 가운데 하나라도 "2박 3일"을 담고 있으면 True 입니다. 숫자로 보이지 않는 "잊은 것"을 확인하는 방법입니다.ax.axhline(…)은 가로선(horizontal line)을 긋습니다. 선 그래프가 이 점선에 닿으면 기록을 모두 보낸 것입니다.