1장. 과정 소개와 LLM 의 이해
확률과 온도
점심 메뉴를 고를 때를 떠올려 보세요. 컨디션이 무난한 날은 늘 먹던 김치찌개를 고릅니다. 기분이 들뜬 날은 평소에 잘 안 먹던 메뉴에도 손이 갑니다. LLM 에게 이 기분을 정해 주는 값이 온도입니다. 온도가 낮으면 늘 1등 낱말을, 높으면 여러 낱말을 골고루 고릅니다.
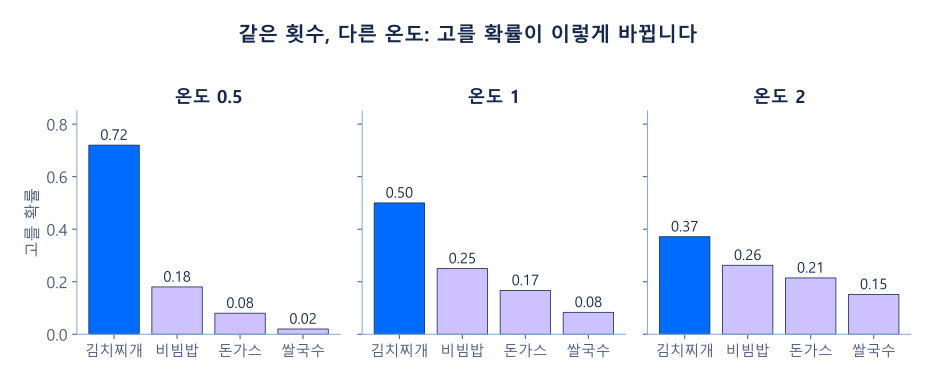
세 칸은 같은 메뉴 네 가지(지난 열두 번 동안 고른 횟수 6, 3, 2, 1)를 온도만 바꿔 확률로 나타낸 것입니다. 왼쪽 온도 0.5 에서는 파랑 막대(김치찌개)가 훨씬 길어지고, 오른쪽 온도 2 에서는 네 막대의 길이가 서로 비슷해집니다. 가운데 온도 1 은 고른 횟수의 비율 그대로입니다. 여기서 김치찌개가 1등 낱말이고, 그날의 기분이 온도입니다.
온도가 하는 계산
중학교에서 배운 거듭제곱과 제곱근이면 충분합니다.
| 단계 | 하는 일 | 예: 횟수 6, 3, 2, 1 |
|---|---|---|
| 1 | 횟수를 (1 ÷ 온도) 제곱한다 | 온도 0.5 → 2제곱: 36, 9, 4, 1 |
| 2 | 모두 더한다 | 36 + 9 + 4 + 1 = 50 |
| 3 | 하나씩 합으로 나눈다 | 0.72, 0.18, 0.08, 0.02 |
온도가 0.5 이면 2제곱을 하므로 큰 수가 훨씬 더 커져 1등이 거의 다 가져갑니다. 온도가 2 이면 2분의 1 제곱, 곧 제곱근을 하므로 큰 수와 작은 수의 차이가 줄어듭니다. 온도가 1 이면 1제곱이라 처음 비율 그대로입니다.
| 온도 | 고르는 모습 | 어울리는 일 |
|---|---|---|
| 0 에 가깝게 | 거의 늘 1등을 고른다. 다시 물어도 비슷한 답 | 규정 안내, 요약, 정해진 형식의 답 |
| 1 쯤 | 배운 비율대로 고른다 | 보통의 대화 |
| 1 보다 크게 | 드문 낱말도 자주 고른다. 엉뚱해지기 쉽다 | 이름 짓기, 아이디어 내기 |
짧은 예시
위의 표를 NumPy 로 계산합니다. ** 는 거듭제곱입니다.
import numpy as np

counts = np.array([6, 3, 2, 1])   # 김치찌개, 비빔밥, 돈가스, 쌀국수를 고른 횟수

for t in [0.5, 1, 2]:
    w = counts ** (1 / t)          # 1단계: (1 ÷ 온도) 제곱
    p = w / w.sum()                # 2·3단계: 합으로 나눠 확률로
print(f"온도 {t}:", p.round(2).tolist())온도 0.5: [0.72, 0.18, 0.08, 0.02]
온도 1: [0.5, 0.25, 0.17, 0.08]
온도 2: [0.37, 0.26, 0.21, 0.15]온도 0.5 에서 김치찌개의 확률은 0.72 로, 온도 1 의 0.5 보다 커졌습니다. 온도 2 에서는 0.37 로 줄고, 쌀국수가 0.08 에서 0.15 로 늘었습니다.
코드가 의미하는 것
이 코드는 앞의 "온도가 하는 계산" 표의 세 단계를 그대로 옮긴 것입니다. 같은 횟수(그동안 고른 경험)에 온도(그날의 기분)만 바꿔 넣고, 확률이 어떻게 바뀌는지 봅니다.
| 코드 | 하는 일 | 챗봇에서 뜻하는 것 |
|---|---|---|
counts = np.array([6, 3, 2, 1]) | 메뉴 네 가지를 고른 횟수를 둔다 | 모델이 다음 낱말 후보마다 가진 점수에 해당합니다. 이 숫자는 온도와 상관없이 그대로입니다 |
for t in [0.5, 1, 2] | 온도를 세 가지로 바꿔 가며 계산한다 | 같은 모델에 온도만 다르게 주고 묻는 것과 같습니다 |
counts ** (1 / t) | 횟수를 (1 ÷ 온도) 제곱한다 | 온도가 낮으면 큰 점수를 더 크게, 높으면 점수 차이를 줄입니다. 온도가 하는 일의 전부가 이 한 줄에 있습니다 |
w / w.sum() | 합으로 나눠 확률로 만든다 | 바뀐 점수를 다시 "다 더하면 1"인 확률로 맞춥니다 |
p.round(2).tolist() | 소수 둘째 자리로 줄여 목록으로 찍는다 | 읽기 좋게 보이려는 것일 뿐 계산에는 영향이 없습니다 |
결과에서 읽을 것은 세 가지입니다.
- 차례는 그대로, 몫만 바뀝니다. 세 줄 모두 김치찌개가 1등, 쌀국수가 꼴찌입니다. 온도는 순위를 뒤집지 않고, 1등이 얼마나 많이 가져가는지만 바꿉니다.
- 낮은 온도는 한결같은 답, 높은 온도는 다양한 답. 온도 0.5 에서는 1등이 0.72 를 가져가 거의 늘 같은 것을 고릅니다. 온도 2 에서는 꼴찌도 0.15 를 받아 가끔 뽑힙니다. 규정 안내에는 낮은 온도, 아이디어 내기에는 높은 온도가 어울리는 까닭입니다.
- 온도 1 은 경험 그대로입니다. 가운데 줄 0.5, 0.25, 0.17, 0.08 은 6, 3, 2, 1 을 12 로 나눈 값과 같습니다. 1제곱은 아무것도 바꾸지 않기 때문입니다.
주의할 점
- 실제 LLM 은 횟수 대신 "점수"에서 시작하고 계산식도 조금 다르지만, 온도가 하는 일은 같습니다. 낮추면 1등이 더 많이 가져가고, 높이면 골고루 나뉩니다.
- 온도를 높여도 확률이 0 인 낱말은 나오지 않습니다. 0 은 몇 제곱을 해도 0 입니다.
- OpenAI 의 모델 가운데에는 온도를 바꿀 수 없는 것도 있습니다. 2장에서 쓰는 모델의 설명서를 확인합니다.