1장. 과정 소개와 LLM 의 이해
프로젝트 1 — 대화 비용 계산기 만들기
구름다리여행의 여행 비서가 손님과 열 번 주고받은 대화(chat_log.json)가 있습니다. 대화는 연습용으로 지어낸 것입니다. 이 대화를 다시 돌린다고 할 때, 요청마다 앞의 대화를 모두 보내는 방식과 최근 메시지 네 개만 보내는 방식이 토큰과 요금에서 얼마나 차이 나는지 계산해 보세요. 그리고 최근 네 개만 보내면 무엇을 잃는지도 확인해 보세요.
| 항목 | 내용 |
|---|---|
| 파일 | chat_log.json. 시스템 메시지 1개와 사용자·어시스턴트 메시지 열 쌍, 모두 21개 |
| 메시지 꼴 | {"role": "user", "content": "…"}. 역할은 system, user, assistant |
| 가정한 단가 | 100만 토큰당 입력 1달러(실습 3과 같은 가정값) |
요구사항은 다섯 가지입니다.
- 메시지마다 토큰 수를 세어 표로 만듭니다.
- 열 번의 요청마다 "모두 보내기"(시스템 + 앞의 모든 메시지 + 새 질문)의 입력 토큰을 구합니다.
- 같은 요청마다 "최근 4개만"(시스템 + 바로 앞 메시지 4개 + 새 질문)의 입력 토큰을 구합니다.
- 두 방식의 요청별 입력 토큰을 선 그래프로 그리고, 열 번의 합과 대화 1,000번의 입력 요금을 견줍니다.
- 마지막 요청("지금까지 말한 일정을 정리해 주세요")에서 "최근 4개만" 방식이 "2박 3일"과 "아이 둘"을 볼 수 있는지 확인하고, 두 방식의 장단점을 두세 문장으로 적습니다.
단계별 힌트입니다.
- json 파일은
json.loads(Path("chat_log.json").read_text(encoding="utf-8"))로 읽습니다. 사전의 목록이 됩니다. - 토큰은 실습 3처럼
tiktoken.get_encoding("o200k_base")의encode로 셉니다. - 메시지 목록에서 사용자 메시지는 1, 3, 5, … 번째 자리(0 부터 셀 때)에 있습니다. t 번째 질문(0 부터)의 자리는
1 + 2 * t입니다. - "모두 보내기"는
msgs[: 1 + 2 * t + 1], "최근 4개만"은[msgs[0]] + msgs[max(1, 1 + 2 * t - 4): 1 + 2 * t + 1]입니다. 앞의 것은 시스템부터 새 질문까지 전부이고, 뒤의 것은 시스템에 새 질문 바로 앞의 넷과 새 질문을 붙인 것입니다. - 글이 들어 있는지는
any("2박 3일" in m["content"] for m in 보낸_메시지)로 확인합니다.
확인할 것: 다 풀었으면 항목마다 스스로 확인해 체크해 보세요.
| 채점 기준 | 배점 |
|---|---|
| 메시지별 토큰 표가 맞다 | 20 |
| 두 방식의 요청별 토큰을 바르게 구했다 | 30 |
| 그래프와 요금 견주기가 있다 | 20 |
| 잃는 정보를 코드로 확인했다 | 15 |
| 장단점을 결과 숫자에 기대어 적었다 | 15 |
코드의 흐름
예시 풀이의 코드가 어떤 차례로 흘러가는지 한 장으로 그렸습니다. 풀기 전에 큰 줄기를 먼저 보고, 풀다가 막히면 지금 어느 상자에 있는지 확인해 보세요.
상자 하나가 예시 풀이의 단계 하나이고, 회청 화살표를 따라가면 실행 차례입니다. 상자 아래의 글은 그 단계에서 쓰는 핵심 코드입니다. 2단계에서 두 방식의 숫자를 구해 3단계에서 나란히 놓고, 4단계에서 숫자(요금)와 숫자로 드러나지 않는 것(잃는 정보)을 함께 봅니다.
실제 데이터로 해 보려면
실제 대화로 같은 계산을 해 볼 수 있습니다. 내려받기 전에 자료마다 이용 약관을 확인하고, 내 대화를 쓸 때는 이름과 연락처 같은 개인정보를 지운 뒤 씁니다.
| 자료 | 구하는 곳 | 내용 |
|---|---|---|
| 내 챗봇 대화 | ChatGPT 의 설정에서 데이터 내보내기 | 내가 나눈 대화가 json 으로 내려받아진다. 개인정보를 지우고 쓴다 |
| AI Hub 의 한국어 대화 데이터 | AI Hub 누리집(회원 가입 후 신청) | 주제별 일상 대화. 신청과 승인이 필요하다 |
내보낸 대화는 서비스마다 json 의 짜임이 다릅니다. 역할과 내용을 꺼내 {"role": …, "content": …} 목록으로 바꾸면 아래 풀이를 그대로 쓸 수 있습니다.
결과 보기 (예시 풀이)
1단계. 대화 읽고 메시지마다 토큰 세기
import json
from pathlib import Path

import pandas as pd
import tiktoken

# 사전의 목록으로 읽는다: [{"role": ..., "content": ...}, ...]
msgs = json.loads(Path("chat_log.json").read_text(encoding="utf-8"))
enc = tiktoken.get_encoding("o200k_base")

# 메시지마다 역할, 토큰 수, 내용 앞부분을 표로 만든다
tokens = pd.DataFrame({
    "역할": [m["role"] for m in msgs],
    "토큰 수": [len(enc.encode(m["content"])) for m in msgs],
    "내용": [m["content"][:18] for m in msgs],
})
print("메시지 수:", len(msgs))
print(tokens.head(5).to_string())
# 역할마다 토큰 수를 더한다
print(tokens.groupby("역할")["토큰 수"].sum())메시지 수: 21
역할 토큰 수 내용
0 system 25 너는 구름다리여행의 친절한 여행
1 user 13 다음 달에 제주도 여행을 가려고
2 assistant 15 좋습니다. 며칠 일정으로 생각하고
3 user 15 2박 3일이요. 아이 둘이랑 가요
4 assistant 19 아이와 함께라면 이동이 짧은 동쪽
역할
assistant 202
system 25
user 122
Name: 토큰 수, dtype: int64코드가 의미하는 것 chat_log.json 의 메시지마다 encode 로 토큰을 세어, 대화의 어느 부분이 무거운지 봅니다. 역할마다 더한 결과에서 어시스턴트의 답이 가장 많은 토큰을 차지했습니다. 챗봇의 답이 길면 다음 요청부터 그 답까지 함께 보내야 하므로, 답의 길이가 다음 요청의 요금에도 영향을 줍니다.
2단계. 요청마다 두 방식의 입력 토큰 구하기
def count(messages):
    """메시지 목록의 토큰 수를 모두 더한다."""
    return sum(len(enc.encode(m["content"])) for m in messages)


rows = []
for t in range(10):
    q = 1 + 2 * t                                    # t 번째 질문의 자리
    full = msgs[: q + 1]                             # 시스템부터 새 질문까지 모두
    window = [msgs[0]] + msgs[max(1, q - 4): q + 1]  # 시스템 + 바로 앞 4개 + 새 질문
    rows.append({"요청": t + 1, "모두 보내기": count(full), "최근 4개만": count(window)})

compare = pd.DataFrame(rows).set_index("요청")
print(compare.T.to_string())요청 1 2 3 4 5 6 7 8 9 10
모두 보내기 38 68 100 133 163 193 228 258 288 317
최근 4개만 38 68 100 105 101 99 101 100 98 96코드가 의미하는 것 full 과 window 는 같은 대화에서 모델에게 보낼 메시지를 고르는 두 가지 규칙입니다. full 은 처음부터 지금까지 전부, window 는 시스템 메시지와 최근 넷과 새 질문만 고릅니다. 4장에서 배우는 메모리 전략이 바로 "보낼 메시지를 고르는 규칙"이며, 이 두 줄이 그 가장 단순한 모습입니다.
3단계. 그래프로 견주기
import matplotlib.pyplot as plt

# 한글 글꼴과 빼기 기호 설정
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# marker="o": 요청마다 점을 찍는다
ax = compare.plot(marker="o", figsize=(7.5, 3.8))
ax.set_title("요청마다 보내는 입력 토큰")
ax.set_xlabel("몇 번째 요청")
ax.set_ylabel("입력 토큰 수")
ax.set_xticks(range(1, 11))
plt.show()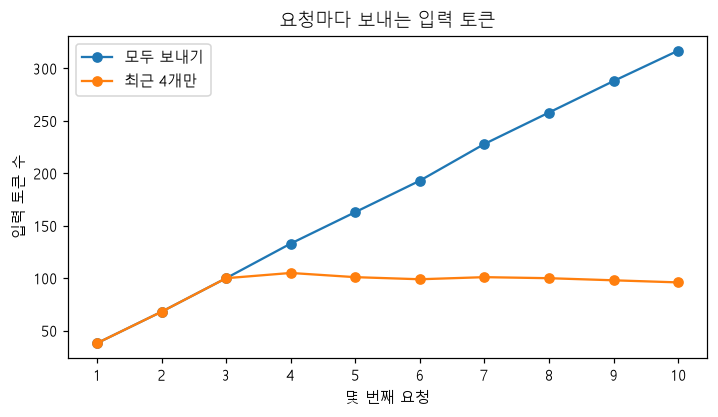
코드가 의미하는 것 요청마다의 입력 토큰을 선 그래프로 그리면 두 규칙의 성격이 드러납니다. 모두 보내기는 오른쪽으로 갈수록 계속 올라가고, 최근 4개만은 어느 순간부터 평평해집니다. 대화가 길어질 때 요금이 계속 늘어나는 쪽과 일정하게 묶이는 쪽의 차이입니다.
4단계. 요금과 잃는 정보 확인하기
# 가정한 단가: 100만 토큰당 입력 1달러 (실습 3과 같은 가정값)
PRICE_IN = 1.0
totals = compare.sum()
for name, total in totals.items():
    cost = total * PRICE_IN / 1_000_000 * 1000       # 대화 1,000번의 입력 요금
    print(f"{name}: 열 번 합 {int(total)} 토큰, 대화 1,000번 {cost:.2f}달러")
print("줄어든 비율:", round(1 - totals["최근 4개만"] / totals["모두 보내기"], 3))

# 마지막 요청에서 "최근 4개만" 방식이 보내는 메시지
q = 1 + 2 * 9
window = [msgs[0]] + msgs[q - 4: q + 1]
for fact in ["2박 3일", "아이 둘"]:
print(f"'{fact}' 을 볼 수 있나:", any(fact in m["content"] for m in window))모두 보내기: 열 번 합 1786 토큰, 대화 1,000번 1.79달러
최근 4개만: 열 번 합 906 토큰, 대화 1,000번 0.91달러
줄어든 비율: 0.493
'2박 3일' 을 볼 수 있나: False
'아이 둘' 을 볼 수 있나: False모두 보내기는 요청마다 30 토큰 안팎씩 늘어 열 번째 요청에서 317 토큰이 됐습니다. 최근 4개만 보내는 쪽은 넷째 요청부터 100 토큰 안팎에 머뭅니다. 열 번의 합은 1,786 과 906 으로, 보내는 토큰이 0.493, 곧 절반쯤 줄었습니다. 가정한 단가로 대화 1,000번이면 1.79달러와 0.91달러입니다. 그런데 마지막 요청("지금까지 말한 일정을 정리해 주세요")에서 최근 4개만 보내면 "2박 3일"도 "아이 둘"도 모델에게 가지 않습니다. 이 방식으로는 일정 정리를 제대로 할 수 없습니다. 아끼는 만큼 잊어버리는 것입니다. 앞의 대화를 짧게 요약해 함께 보내는 방법(Summary 메모리)이 이 둘 사이를 메우며, 4장에서 견줘 봅니다.
코드가 의미하는 것 앞부분은 토큰 합에 가정한 단가를 곱해 대화 1,000번의 요금을 견주고, 뒷부분은 any(fact in m["content"] ...) 로 마지막 요청에 중요한 사실이 담겨 가는지 확인합니다. 요금처럼 숫자로 드러나는 이득과, 잊어버리는 정보처럼 숫자로 드러나지 않는 손해를 함께 따져야 메모리 전략을 고를 수 있다는 것을 코드로 보인 것입니다.
이 프로젝트가 뜻하는 것
이 프로젝트는 상담 기록 메모를 넘길 때 "전부 복사해 줄까, 최근 몇 장만 줄까"를 정하는 일과 같습니다. 메모의 장마다 분량을 재고(1단계), 두 방식으로 넘길 때의 분량을 요청마다 구하고(2단계), 그림으로 견주고(3단계), 복사비와 빠뜨린 내용을 따집니다(4단계). 여기서 복사비가 입력 요금, 빠뜨린 내용이 잃는 정보입니다. 비유와 다른 점은, 사람은 빠진 내용을 다시 물어보지만 LLM 은 받은 것만으로 그럴듯하게 답해 버릴 수 있다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 메시지별 토큰 | 메시지 21개, 사용자 122, 어시스턴트 202, 시스템 25 | 답이 질문보다 길어서 어시스턴트 쪽 토큰이 더 많습니다 |
| 2. 모두 보내기 | 38 → 317 | 요청마다 앞의 질문과 답이 쌓여 계속 늘어납니다 |
| 2. 최근 4개만 | 38, 68, 100 뒤로 96~105 | 넷째 요청부터는 보내는 양이 거의 그대로입니다 |
| 4. 합과 요금 | 1,786 대 906, 0.493 줄어듦 | 열 번만 주고받아도 보내는 토큰이 절반쯤으로 줄었습니다(가정 단가로 1.79달러 대 0.91달러) |
| 4. 잃는 정보 | 2박 3일 False, 아이 둘 False | 최근 4개만 보내면 앞에서 말한 일정을 모델이 볼 수 없습니다 |
한 줄로 줄이면, 대화 기록을 모두 보내면 요금이 계속 늘고, 최근 것만 보내면 요금은 줄지만 앞의 내용을 잊는다는 것을 숫자로 확인한 프로젝트입니다. 둘 가운데 무엇이 옳다기보다 챗봇의 쓰임에 따라 고릅니다. 한두 번 묻고 끝나는 FAQ 챗봇은 최근 몇 개면 충분하고, 일정을 함께 짜는 여행 비서는 앞의 내용을 지켜야 합니다. 대화는 지어낸 열 번짜리라 숫자가 작지만, 실제 서비스에서는 대화가 길고 손님이 많아 차이가 훨씬 커집니다.