1장. 과정 소개와 LLM 의 이해
실습 3 — 토큰 세고 요금 어림하기
tiktoken 으로 문장을 토큰으로 썰어 보고, 같은 뜻의 한국어 문장과 영어 문장의 토큰 수를 견줍니다. 마지막으로 챗봇 질문 한 번의 토큰으로 요금을 어림합니다. 요금 계산에 쓰는 단가는 계산 연습을 위해 정한 가정값이고 실제 단가가 아닙니다. 토큰 사전을 처음 받을 때 인터넷이 필요합니다.
1단계. 문장 하나 썰어 보기
import tiktoken

# o200k_base: GPT-4o 계열 모델이 쓰는 토큰 사전
enc = tiktoken.get_encoding("o200k_base")

text = "제주도 여행을 예약하고 싶어요."
# encode: 글 → 토큰 번호 목록
ids = enc.encode(text)

print("토큰 번호:", ids)
# decode([i]): 번호 하나를 다시 글 조각으로 바꿔 어떻게 썰렸는지 본다
print("토큰 조각:", [enc.decode([i]) for i in ids])
print("글자 수:", len(text), "/ 토큰 수:", len(ids))토큰 번호: [8021, 9273, 5827, 106857, 3281, 150076, 17231, 65727, 84959, 13]
토큰 조각: ['제', '주', '도', ' 여행', '을', ' 예약', '하고', ' 싶', '어요', '.']
글자 수: 17 / 토큰 수: 10코드가 의미하는 것 본문 "토큰" 절의 예시를 실제 챗봇 질문 한 줄로 해 본 것입니다. encode 가 돌려준 번호 열 개가 모델에게 실제로 가는 것이고, len(ids) 의 10 이 요금과 길이 제한을 셀 때 쓰는 숫자입니다. 17글자인데 10토큰이므로, 글자 수로 요금을 어림하면 틀린다는 것을 확인합니다.
2단계. 한국어와 영어 견주기
import pandas as pd

# 같은 뜻의 한국어·영어 문장 네 쌍
pairs = [
    ("안녕하세요", "Hello"),
    ("제주도 여행을 예약하고 싶어요.", "I want to book a trip to Jeju."),
    ("출발 7일 전까지 무료로 바꿀 수 있습니다.", "You can change it for free up to 7 days before departure."),
    ("아이와 함께라면 동쪽 해안 일정을 추천드립니다.", "With kids, I recommend the east coast itinerary."),
]

rows = []
for no, (ko, en) in enumerate(pairs, start=1):
    for lang, sentence in [("한국어", ko), ("영어", en)]:
        rows.append({"쌍": no, "언어": lang, "글자 수": len(sentence), "토큰 수": len(enc.encode(sentence))})

table = pd.DataFrame(rows)
print(table.to_string(index=False))
# 언어마다 토큰 하나에 글자가 몇 개 들어가는지 평균을 낸다
sums = table.groupby("언어")[["글자 수", "토큰 수"]].sum()
print((sums["글자 수"] / sums["토큰 수"]).round(2)) 쌍 언어 글자 수 토큰 수
1 한국어 5 2
1 영어 5 1
2 한국어 17 10
2 영어 30 10
3 한국어 24 15
3 영어 57 14
4 한국어 26 14
4 영어 48 10
언어
영어 4.00
한국어 1.76
dtype: float64코드가 의미하는 것 같은 뜻의 문장을 언어만 바꿔 encode 의 길이를 견줍니다. 글자 수 / 토큰 수 는 토큰 하나에 글자가 몇 개 들어가는지로, 클수록 같은 글을 적은 토큰으로 보낸다는 뜻입니다. 같은 내용이라도 어느 언어로 쓰느냐에 따라 보내는 토큰, 곧 요금과 길이가 달라질 수 있다는 것을 숫자로 봅니다.
3단계. 그래프로 보기
import matplotlib.pyplot as plt

# 한글 글꼴과 빼기 기호 설정
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# pivot: 쌍을 행으로, 언어를 열로 펼쳐 막대를 나란히 그릴 표를 만든다
wide = table.pivot(index="쌍", columns="언어", values="토큰 수")[["한국어", "영어"]]
ax = wide.plot.bar(rot=0, figsize=(7, 3.8))
ax.set_title("같은 뜻의 문장, 언어마다 다른 토큰 수")
ax.set_xlabel("문장 쌍 번호")
ax.set_ylabel("토큰 수")
plt.show()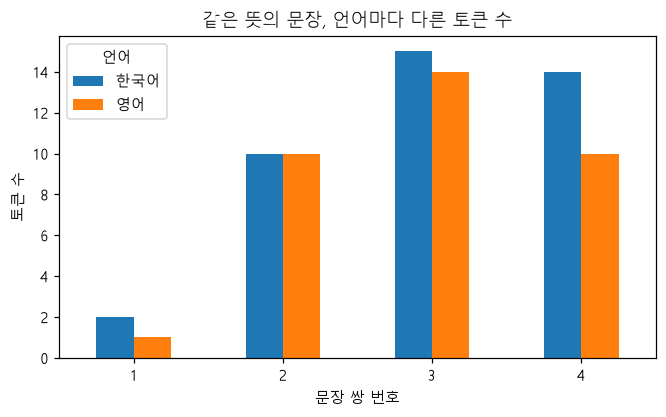
코드가 의미하는 것 pivot 으로 표를 펼쳐 쌍마다 한국어와 영어 막대를 나란히 세웁니다. 숫자 표에서는 지나치기 쉬운 차이를 눈으로 보려는 것으로, 그래프는 계산을 바꾸지 않고 2단계의 결과를 다시 보여 줄 뿐입니다.
4단계. 요금 어림하기
# 가정한 단가: 100만 토큰당 입력 1달러, 출력 4달러
# 실제 단가는 모델마다 다르고 자주 바뀌므로 OpenAI 가격 페이지에서 확인한다
PRICE_IN, PRICE_OUT = 1.0, 4.0

question = "출발 7일 전까지 예약을 바꿀 수 있나요?"
answer = "출발 7일 전까지 마이페이지에서 한 번 무료로 바꿀 수 있습니다."
tok_in, tok_out = len(enc.encode(question)), len(enc.encode(answer))

# 한 번 물을 때의 요금 = 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가 (단가는 100만 토큰당이라 100만으로 나눈다)
per_call = (tok_in * PRICE_IN + tok_out * PRICE_OUT) / 1_000_000
calls = 1000 * 10   # 손님 1,000명이 10번씩 묻는다고 가정

print("입력 토큰:", tok_in, "/ 출력 토큰:", tok_out)
print(f"한 번에 {per_call:.6f}달러")
print(f"{calls:,}번이면 {per_call * calls:.2f}달러")입력 토큰: 16 / 출력 토큰: 21
한 번에 0.000100달러
10,000번이면 1.00달러코드가 의미하는 것 (입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가) ÷ 1,000,000 은 API 요금을 매기는 방식을 그대로 옮긴 식입니다. 입력과 출력의 단가를 따로 둔 것은 실제로도 둘의 값이 다르기 때문이고, 출력 단가를 높게 잡은 이 가정에서는 답 쪽이 요금의 대부분을 차지했습니다. 단가는 가정값이라 숫자보다 "토큰 수 × 단가"라는 계산 방법을 가져가면 됩니다.
이 실습이 뜻하는 것
이 실습은 가래떡을 썰어 보고 떡값을 어림하는 일과 같습니다. 문장 하나를 썰어 조각을 보고(1단계), 같은 뜻의 한국어와 영어 문장이 몇 조각으로 썰리는지 견주고(2·3단계), 조각 수로 값을 어림합니다(4단계). 여기서 떡 조각이 토큰, 떡값이 API 요금입니다. 비유와 다른 점은, 실제 요금은 보낸 토큰(입력)과 받은 토큰(출력)의 단가가 서로 다르다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 썰어 보기 | 글자 17, 토큰 10 | "제주도"가 '제', '주', '도' 세 조각으로 썰렸습니다. " 여행", " 예약"처럼 앞의 띄어쓰기가 붙은 조각도 있습니다 |
| 2. 언어 견주기 | 토큰 하나에 영어 4.00글자, 한국어 1.76글자 | 영어는 토큰 하나에 글자가 많이 들어가고, 한국어는 적게 들어갑니다 |
| 2·3. 쌍마다 | 넷째 쌍 한국어 14, 영어 10 | 같은 뜻이라도 한국어가 토큰을 더 쓰는 쌍이 많았습니다. 둘째 쌍은 둘 다 10 으로 같았습니다 |
| 4. 요금 | 입력 16, 출력 21, 한 번에 0.0001달러 | 가정한 단가로 계산하면 1만 번 물어도 1달러입니다 |
한 줄로 줄이면, 토큰 수는 글자 수와 다르고 언어마다 다르며, 요금은 그 토큰 수에 비례한다는 것을 확인한 실습입니다. 4단계에서 입력은 16 × 1 = 16, 출력은 21 × 4 = 84 로, 요금의 대부분이 답(출력) 쪽에서 나왔습니다. 답을 짧게 하라는 지시가 요금을 줄이는 까닭입니다. 단가는 가정값이므로 실제 요금은 쓰는 모델의 가격표로 다시 계산합니다.
코드 설명
enc.encode(text)는 글을 토큰 번호 목록으로,enc.decode([i])는 번호 하나를 글 조각으로 돌려 줍니다. 조각을 이어 붙이면 원래 문장이 됩니다.table.groupby("언어")[["글자 수", "토큰 수"]].sum()은 언어마다 글자 수와 토큰 수를 더합니다. 합끼리 나눈 값이 "토큰 하나에 든 글자 수"입니다.table.pivot(index="쌍", columns="언어", values="토큰 수")는 세로로 긴 표를 쌍 × 언어의 가로 표로 펼칩니다. 이 꼴이어야plot.bar가 막대를 나란히 그립니다.per_call의 식에서 1,000,000 으로 나누는 것은 단가가 "100만 토큰당"이기 때문입니다. 토큰 16개는 100만 토큰의 0.000016 배입니다.