1장. 과정 소개와 LLM 의 이해
실습 4 — 온도로 낱말 고르기 바꾸기
실습 2에서 저장한 횟수표(out_next_word.json)로 "제주도" 다음 낱말의 확률을 온도 0.5, 1, 2 에서 구하고, 온도마다 천 번씩 뽑아 봅니다. 실습 2를 먼저 해야 파일이 있습니다. 뽑기는 난수를 쓰므로 씨앗을 42 로 고정해, 다시 돌려도 같은 결과가 나오게 합니다.
1단계. 횟수표 불러오기
import json
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np

# 한글 글꼴과 빼기 기호 설정
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 실습 2가 저장한 {낱말: {뒤에 온 낱말: 횟수}} 표를 읽는다
next_words = json.loads(Path("out_next_word.json").read_text(encoding="utf-8"))

counts = next_words["제주도"]
words = list(counts)                                   # 후보 낱말 목록
n = np.array(list(counts.values()), dtype=float)       # 같은 순서의 횟수
print("후보:", words)
print("횟수:", n.tolist())후보: ['여행은', '여행을', '날씨가', '맛집을']
횟수: [9.0, 4.0, 3.0, 5.0]코드가 의미하는 것 실습 2가 저장한 out_next_word.json 을 다시 읽는 것은, 배운 모델을 파일에서 불러와 쓰는 일과 같습니다. 학습(세기)은 한 번 하고, 쓸 때는 저장된 결과만 불러옵니다. np.array(..., dtype=float) 는 다음 단계의 거듭제곱 계산을 하려고 횟수를 숫자 배열로 바꾼 것입니다.
2단계. 온도마다 확률 구하기
import pandas as pd


def probs(n, temperature):
    """횟수를 (1 ÷ 온도) 제곱한 뒤 합으로 나눠 확률로 바꾼다."""
    w = n ** (1 / temperature)
    return w / w.sum()


TEMPS = [0.5, 1.0, 2.0]
# 열마다 온도 하나, 행마다 후보 낱말 하나인 확률표
table = pd.DataFrame({f"온도 {t}": probs(n, t).round(3) for t in TEMPS}, index=words)
print(table) 온도 0.5 온도 1.0 온도 2.0
여행은 0.618 0.429 0.335
여행을 0.122 0.190 0.223
날씨가 0.069 0.143 0.193
맛집을 0.191 0.238 0.249코드가 의미하는 것 probs 함수는 본문 "확률과 온도" 절의 계산을 함수 하나로 묶은 것입니다. 표의 열마다 같은 횟수에 온도만 다르게 넣었으므로, 열끼리의 차이가 곧 온도가 하는 일입니다. 실제 API 에서 temperature 값을 바꾸는 것이 모델 안에서 이런 확률 조정을 일으킵니다.
3단계. 그래프로 견주기
# 행이 낱말, 열이 온도인 표를 그대로 묶음 막대로 그린다
ax = table.plot.bar(rot=0, figsize=(7.5, 3.8))
ax.set_title("'제주도' 다음 낱말의 확률: 온도에 따라")
ax.set_xlabel("후보 낱말")
ax.set_ylabel("확률")
plt.show()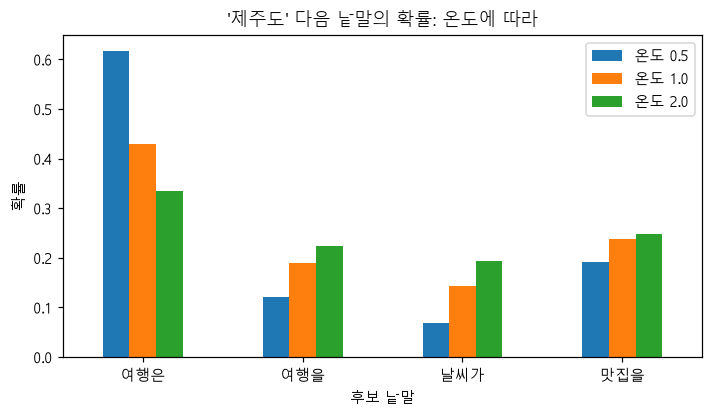
코드가 의미하는 것 확률표를 묶음 막대로 그려 온도마다 막대 높이가 어떻게 달라지는지 봅니다. 낮은 온도에서는 1등 막대만 우뚝 솟고, 높은 온도에서는 막대들이 고르게 됩니다. 계산은 2단계에서 끝났고, 이 그림은 그 결과를 한눈에 보려는 것입니다.
4단계. 천 번씩 뽑아 보기
from collections import Counter

# default_rng(42): 씨앗 42 로 고정한 난수 생성기. 다시 돌려도 같은 결과가 나온다
rng = np.random.default_rng(42)

for t in TEMPS:
    # choice(후보, size=뽑을 수, p=확률): 확률대로 천 번 뽑는다. 적게 뽑으면 우연에 크게 흔들린다
    picks = rng.choice(words, size=1000, p=probs(n, t))
    # numpy 글자를 보통 글자로 바꿔 센다
    print(f"온도 {t}:", dict(Counter(str(w) for w in picks).most_common()))

# 기록에 없던 낱말이 후보에 들어 있는지 확인한다
print("'바다는' 이 후보에 있나:", "바다는" in words)온도 0.5: {'여행은': 619, '맛집을': 185, '여행을': 113, '날씨가': 83}
온도 1.0: {'여행은': 419, '맛집을': 252, '여행을': 193, '날씨가': 136}
온도 2.0: {'여행은': 339, '맛집을': 245, '여행을': 234, '날씨가': 182}
'바다는' 이 후보에 있나: False코드가 의미하는 것 rng.choice(words, size=1000, p=...) 는 확률대로 낱말을 천 번 뽑는 것으로, 같은 질문을 모델에게 천 번 했을 때 다음 낱말이 어떻게 나뉘는지 흉내 냅니다. 씨앗(default_rng(42))을 고정한 것은 교안의 결과를 누가 돌려도 같게 하려는 것이고, 실제 모델의 답이 매번 조금씩 다른 까닭은 이 뽑기에 있습니다. 마지막 줄은 기록에 없는 낱말("바다는")은 후보에조차 없어서 어떤 온도에서도 뽑히지 않는다는 것을 확인합니다.
이 실습이 뜻하는 것
이 실습은 점심 메뉴를 기분에 따라 천 번 골라 보는 일과 같습니다. 지난 기록의 횟수를 꺼내고(1단계), 기분(온도)마다 확률을 계산하고(2단계), 그림으로 견주고(3단계), 실제로 천 번씩 골라 봅니다(4단계). 여기서 메뉴가 "제주도" 다음 후보 낱말, 기분이 온도입니다. 비유와 다른 점은, 사람의 기분은 이유가 있지만 온도는 우리가 숫자로 정해 주는 값이라는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 횟수표 | 여행은 9, 여행을 4, 날씨가 3, 맛집을 5 | 실습 2에서 센 그대로입니다. 순서는 문장에 처음 나온 차례입니다 |
| 2. 온도 1.0 | 0.429, 0.190, 0.143, 0.238 | 실습 2의 확률(횟수 ÷ 21)과 똑같습니다. 1제곱은 아무것도 바꾸지 않습니다 |
| 2. 온도 0.5 | 여행은 0.618, 날씨가 0.069 | 2제곱을 하니 1등은 더 커지고 꼴찌는 절반쯤으로 줄었습니다 |
| 2. 온도 2.0 | 여행은 0.335, 날씨가 0.193 | 제곱근을 하니 네 낱말의 몫이 서로 비슷해졌습니다 |
| 4. 천 번 뽑기 | 여행은 619번, 419번, 339번 | 온도 0.5, 1, 2 에서 뽑힌 횟수가 확률표(0.618, 0.429, 0.335)와 거의 같습니다 |
| 4. 바다는 | False | 기록에 없던 "바다는"은 후보에 없으니 어떤 온도에서도 나오지 않습니다 |
한 줄로 줄이면, 온도는 순위는 그대로 두고 몫만 늘리거나 줄인다는 것을 확인한 실습입니다. 세 온도 모두 1등은 "여행은", 꼴찌는 "날씨가"로 순서가 같았습니다. 그래프에서 파랑(온도 0.5) 막대는 1등 "여행은"에서 가장 길고, 초록(온도 2.0) 막대는 네 낱말에서 길이가 가장 고릅니다. 천 번은 많이 뽑은 것이라 확률에 가깝게 나왔고, 스무 번처럼 적게 뽑으면 우연에 따라 크게 흔들립니다.
코드 설명
n ** (1 / temperature)가 온도의 계산입니다. NumPy 배열이라 네 횟수에 한꺼번에 거듭제곱이 적용됩니다.w / w.sum()은 합으로 나눠 확률로 바꿉니다.pd.DataFrame({f"온도 {t}": … for t in TEMPS}, index=words)는 온도마다 열 하나를 만듭니다. 이 표를 그대로table.plot.bar에 넣으면 낱말마다 세 온도의 막대가 묶여 그려집니다.rng.choice(words, size=1000, p=…)는 확률대로 천 번 뽑습니다. 씨앗 42 를 고정했으므로 다시 돌려도 619, 419, 339 가 그대로 나옵니다.- 그래프의 색(파랑, 주황, 초록)은 matplotlib 의 기본 색입니다. 교안의 그림 색과 다르지만, 여러분이 실행했을 때와 같도록 그대로 두었습니다.